

1.AIが当たり前の世界に備えて
2022年末にChatGPTが公開されて以降、生成AIの能力は向上し続けています。初期はチャットでの応答にとどまっていましたが、現在では人間が行うと時間がかかるタスクを、自律的に計画を立てて完遂できるケースも出てきています。図1は、生成AIが50%の成功率で完了できるタスクの長さを、人間の専門家が行ったときにかかる時間で表したものです。この長さは、およそ7か月ごとに倍増しています。
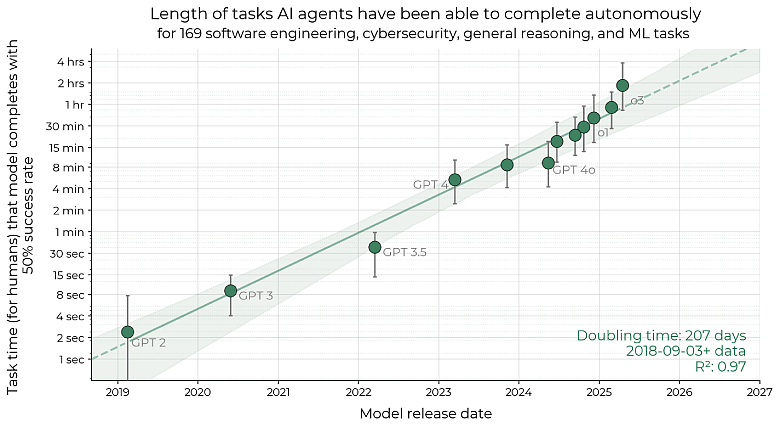
図1:AIエージェントが自律的に完了できるタスクの長さの推移
出典:METR "Measuring AI Ability to Complete Long Tasks" Figure 1(CC BY 4.0)
自律的なタスク完遂が可能になった背景には、3つの技術の発展があります。1つ目は、回答の前に思考を重ね、何をどの順で対応すればよいかを組み立てる「推論(reasoning)」。2つ目は、モデルが必要に応じて外部の環境とやり取りし、情報の取得や一時保存を行う「ツール呼び出し(tool calling)」。3つ目は、モデルの出力を受けてフィードバックを繰り返し、タスクの完了まで制御する「ハーネス(Harness)」です。
各機能の発展に伴い、モデルはユーザーが一度入力したタスクに対して、より多く考え、より多く処理できるようになりました。一方で、1つのタスクを完遂するために以前は想像もできなかった量のトークン(※1)が消費され、モデルの利用費用も膨らみやすくなっています。実際にNTT DATAでも、生成AIを大規模に活用する中で、API利用料が数千万円規模に達したケースがあります。
主要な生成AIモデルでは、モデルの発展に伴って性能あたりの利用単価が急速に低下してきました(※2)が、モデルプロバイダーは、計算資源に巨額の投資を続けており、当面は赤字が続く見通しを示す企業もあります(※3)。そのため、現在の価格低下の傾向や価格水準を今後も維持できるかは不透明です。さらに、1つのタスクで消費するトークン量は増加しており、トークン単価が低下しても、タスク完遂にかかるコストは増大するケースもあります。今後は、モデルのトークン単価も上がりうること、タスクで消費するトークン量が多くなりうることの両方を念頭に置く必要があります。そのうえで、AIを経済的に使いこなせるようになることが求められます。
生成AIがテキストを処理する際の単位。API経由での利用では、入出力のトークン量に応じて課金されるのが一般的です。
2.モデル選びに迷わないためのガイドライン
こうした課題解決の1つのアプローチが、API経由でAIモデルを利用するだけではなく、ローカルモデル(※4)を導入することです。ローカルモデルはトークン量に連動した課金システムではないため、費用を予測しやすく、「気づいたらコストが膨れ上がっていた」という事態を避けやすくなります。さらにローカルモデルには、入力したデータの所在が明確である、オフライン環境で使える、用途に合わせてカスタマイズできるといったメリットもあります。今後AIモデルが普及するにつれて、より一般的な選択肢になると考えられます。
一方で、ローカルモデルも万能ではありません。まず、計算環境の準備にはかなりの投資が必要です。設計や運用の難易度も高く、構成によっては従量課金でモデルを使うより高額になるケースも珍しくありません。
また、性能は、最新のクラウドモデル(※5)に遅れを取る傾向があります。図2に示すように、重みが公開された最高性能のモデルと最先端の非公開モデルとの差は、平均で4か月程度まで縮まってきました。それでも利用者からすると、依然として明確な差として残っています。そのため、クラウドモデルを使う感覚でローカルモデルを使うと、歯がゆい思いをすることも多いでしょう。
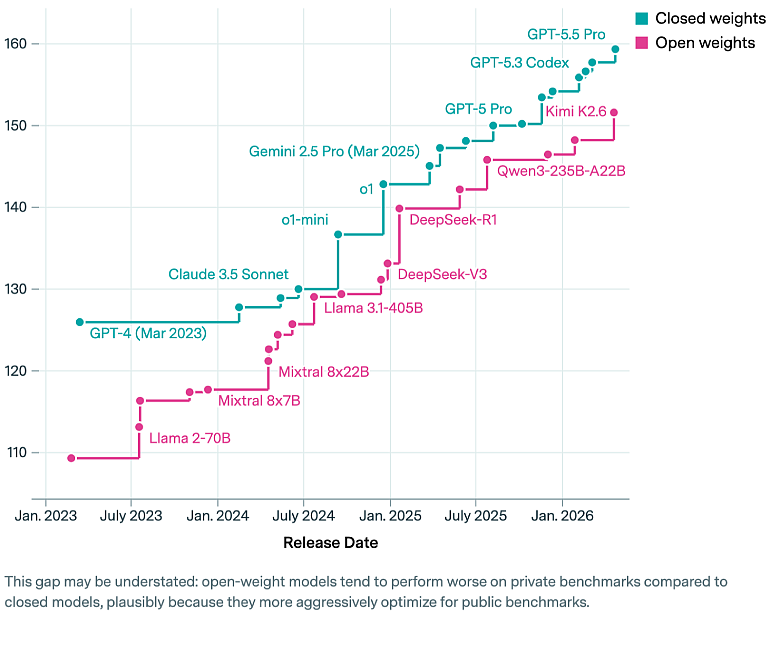
図2:重み公開モデル(Open)と非公開モデル(Closed)の性能指標の推移
出典:Epoch AI "Open models lag state-of-the-art closed models by 4 months"(CC BY 4.0)
そこで、重要になるのが、案件ごとの要件やニーズに合った適切なモデルを選択することです。ただ、個々の案件でクラウドモデルとローカルモデルのどちらを選ぶべきか、性能やコスト、運用性をどう比較するかといった知見は、十分に体系化されていません。実案件の意思決定に必要なこれらの検討を、各プロジェクト内だけで行うのは難しいのが実情です。
こうした課題に対応できるよう、NTT DATAは、ローカルモデルの活用時に期待できるメリットを類型化し、プロジェクトでその効果が得られるかどうかを事前に見積もることができるガイドラインを整備しました。自社の実プロジェクトで得たベストプラクティスや、失敗から得たノウハウを一般化してまとめています。失敗事例は同じ轍を踏まないこと、成功事例は再現できることをめざしました。実際の事例に基づくことで、根拠を持った判断ができる点がポイントです。
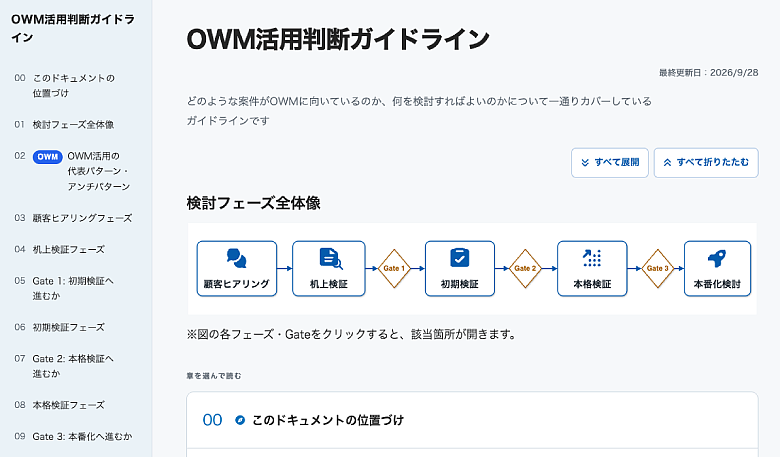
図3:NTT DATAで準備したガイドライン
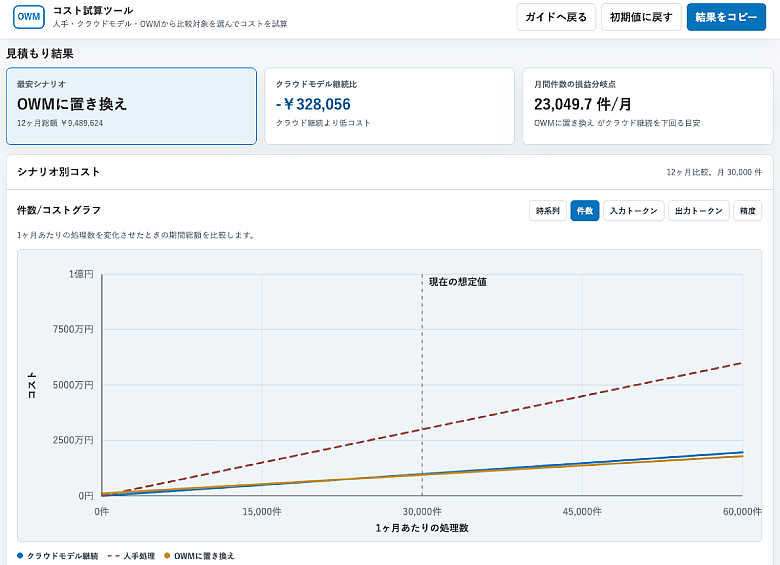
図4:NTT DATAで準備したコスト試算ツール
本記事では、重みが公開されたモデルを、自社で管理する計算環境(オンプレミスや自社で契約したクラウド)で運用するものを指します。
本記事では、ローカルモデルに対し、モデルプロバイダーが提供するAPI経由で推論を行うモデルを指します。
3.人だけではなく、エージェントも活用できるガイドラインへ
ガイドラインは、初めて生成AIのプロジェクトに携わる人でも、プロジェクトに必要な情報を事前に把握し、お客さまと議論できるように作成したため、主要な観点をカバーしています。その分、文字数が多く、最後まで読み切るハードルが高いという課題もありました。最近ではこうしたノウハウ資料を、Codexなどのコーディングエージェント(※6)を介して参照する時代になりつつあるため、本ガイドラインは、通常のテキストに加えてAgent Skills(※7)の形でも整備しています。Skills化により、判断が難しい箇所は生成AIの力を借りつつ、よりプロジェクトの実態に即した形でガイドラインを適用できるようになりました。
ソフトウェア開発の作業を、指示に応じて自律的に進めるAIエージェント。
AIエージェントが必要に応じて読み込めるよう、作業手順や知識をファイルとしてまとめる仕組み。
4.今後の展望
エージェント単体でも、十分な情報を得られることは多くなっています。ただし、自社固有の経験を踏まえることで、より具体的で確度の高い情報を得られることも多いため、知見を一般化して広く展開することは依然として重要です。その第一歩として、NTT DATAでは、ローカルモデルの導入をテーマに、エージェント時代ならではのノウハウ展開に取り組みました。
今後、ローカルモデルの性能を最大限引き出すための使い方のコツをまとめたガイドラインや、実案件の評価データに対して機能面(精度)・非機能面(速度・コスト)の両観点でモデルの性能を測り、適切なモデルを自動選定できるツールも整備・展開していきます。NTT DATAは、これらの取り組みを通じて、性能とコストの両面から、より根拠のあるモデル活用を推進していきます。

生成AI(Generative AI)についてはこちら:
https://www.nttdata.com/jp/ja/services/generative-ai/
あわせて読みたい: